お疲れ様です!IT業界で働くアライグマです!
「AIエージェントを試したいけど、API料金が気になる」「社内データをクラウドに送りたくない」——こうした悩みを抱えるエンジニアの方は少なくありません。
実は、OllamaとCrewAIを組み合わせれば、完全ローカル環境でマルチエージェントシステムを構築できます。API課金ゼロ、データ外部送信ゼロで、複数のAIエージェントが協調して複雑なタスクを自律的に処理する仕組みが手に入るのです。
2025年後半からAIエージェントの実用化が急速に進み、LangChain、AutoGen、CrewAIといったフレームワークが次々と登場しています。中でもCrewAIは「役割ベースのエージェント設計」という直感的なアプローチで、エンジニアからの支持を集めています。
本記事では、OllamaでローカルLLMを動かし、CrewAIでマルチエージェントシステムを構築する手順を、実践的なコード例とともに解説します。
ローカルAIエージェントの全体像と背景
AIエージェントとは、与えられた目標に対して自律的に思考・判断・行動するAIシステムのことです。従来のチャットボットが「質問→回答」の1往復で完結するのに対し、エージェントは複数のステップを自ら計画し、ツールを使い、結果を検証しながらタスクを遂行します。
マルチエージェントシステムでは、さらに複数の専門エージェントが役割分担して協調動作します。たとえば「リサーチャー」がWeb検索で情報を収集し、「ライター」がその情報を元に記事を執筆し、「エディター」が品質チェックを行う——といった分業が可能です。CursorでローカルLLMを活用する方法を解説した記事でも触れた通り、ローカルLLMの性能は飛躍的に向上しており、エージェント用途でも十分な品質を発揮できます。ローカルでAIエージェントを動かすメリットは以下の3点です。
- コスト削減:API課金が発生しないため、大量のリクエストを気兼ねなく実行できる
- プライバシー保護:社内データや個人情報がクラウドに送信されないため、セキュリティポリシーに準拠しやすい
- カスタマイズ性:モデルの選択やファインチューニングを自由に行える
 IT女子 アラ美
 ITアライグマ
ローカルAIエージェントの動作要件とOllama×CrewAI連携の準備
手元のマシンでローカルAIエージェントを動かすにあたり、事前に確認しておきたいスペックや環境を整理しておきましょう。
ハードウェアの目安:GPUとメモリ容量
ローカルLLMを動かす上で最も重要なのがVRAM(ビデオメモリ)の容量です。複数エージェントをスムーズに動かすための目安をまとめました。
- 手軽に試す最小構成:RAM 16GB以上、VRAM 8GB前後のGPU(RTX 3060やApple Silicon Macなど)があれば、8Bクラスのモデルが軽快に動きます。
- 実務で活躍する推奨構成:より複雑な推論をこなす32B〜70Bモデルを動かすなら、RAM 32GB以上、VRAM 16GB〜24GB以上の環境があると安心です。
- CPU推論の注意点:GPUがないPCでもOllamaは動作しますが、エージェントの自律的な試行錯誤には少し時間がかかります。まずは軽量なモデルで動作確認から始めるのがおすすめです。
ソフトウェア環境と必要なツール
開発に使用するライブラリと動作環境は以下の通りです。
- 実行言語:Python 3.10以上を推奨します。
- LLM実行基盤:Ollama(公式サイトからインストーラーをダウンロードして準備します)。
- エージェントフレームワーク:CrewAI(pipコマンドから手軽に導入可能です)。
- 対応OS:macOSはもちろん、UbuntuなどのLinux環境や、Windows(WSL2経由がスムーズです)で快適に動作します。
Ollamaが未導入の方は、ローカルLLM環境構築手順でOllamaのインストールから初期設定までの手順を紹介していますので、そちらを先にご確認ください。
IT女子 アラ美ITアライグマステップ1:OllamaとCrewAIの基本セットアップ
まずは手元の環境でOllamaを起動し、CrewAIから接続してローカルAIエージェントを動かす基本構成を作っていきましょう。
Ollamaのモデル準備
手始めに、エージェント用途に適したローカルモデルをOllamaで準備します。AIエージェントでは、ユーザーからの指示を正確に理解してタスクを細分化する指示追従性の高さが何より重要です。開発機のスペックに合わせて、扱いやすい8Bモデルから試してみるのがおすすめですよ。
- llama3.1:8b:軽量で高速、基本的なエージェントタスクに最適
- qwen2.5:32b:バランス型、複雑な推論にも対応
- llama3.1:70b:高精度、GPT-4oに匹敵する性能
# モデルのダウンロード
ollama pull llama3.1:8b

# 動作確認
ollama run llama3.1:8b "Hello, are you ready to be an agent?"
CrewAIプロジェクトの初期化
続いて、CrewAIを組み込むPythonの実行環境をセットアップします。依存パッケージの競合を防ぐためにも、専用の仮想環境を作ってから必要なライブラリをインストールしていきましょう。
# 仮想環境の作成
python3 -m venv .venv
source .venv/bin/activate

# CrewAIのインストール
pip install crewai crewai-tools
Ollamaとの接続設定
準備が整ったら、CrewAIからローカルのOllamaへ接続するコードを記述します。CrewAIは内部でLiteLLMのOllamaプロバイダーをサポートしているため、ローカルで待ち受けているエンドポイントを指定するだけで、クラウドAPIと同じ感覚でローカルLLMを呼び出せます。
from crewai import Agent, Task, Crew, LLM

# OllamaのローカルLLMを設定
llm = LLM(
    model="ollama/llama3.1:8b",
    base_url="http://localhost:11434"
)

# エージェントの定義
researcher = Agent(
    role="リサーチャー",
    goal="与えられたトピックについて正確な情報を収集する",
    backstory="あなたは経験豊富なリサーチャーです。信頼性の高い情報源から事実を収集し、要点を整理することが得意です。",
    llm=llm,
    verbose=True
)

# タスクの定義
research_task = Task(
    description="AIエージェントの最新トレンドについて調査し、主要な3つのポイントをまとめてください。",
    expected_output="AIエージェントの最新トレンドに関する3つの主要ポイントのレポート",
    agent=researcher
)

# Crewの実行
crew = Crew(
    agents=[researcher],
    tasks=[research_task],
    verbose=True
)

result = crew.kickoff()
print(result)
エージェントに外部ツールを接続する際は、MCPサーバーの自作方法を理解しておくと設計がスムーズになります。
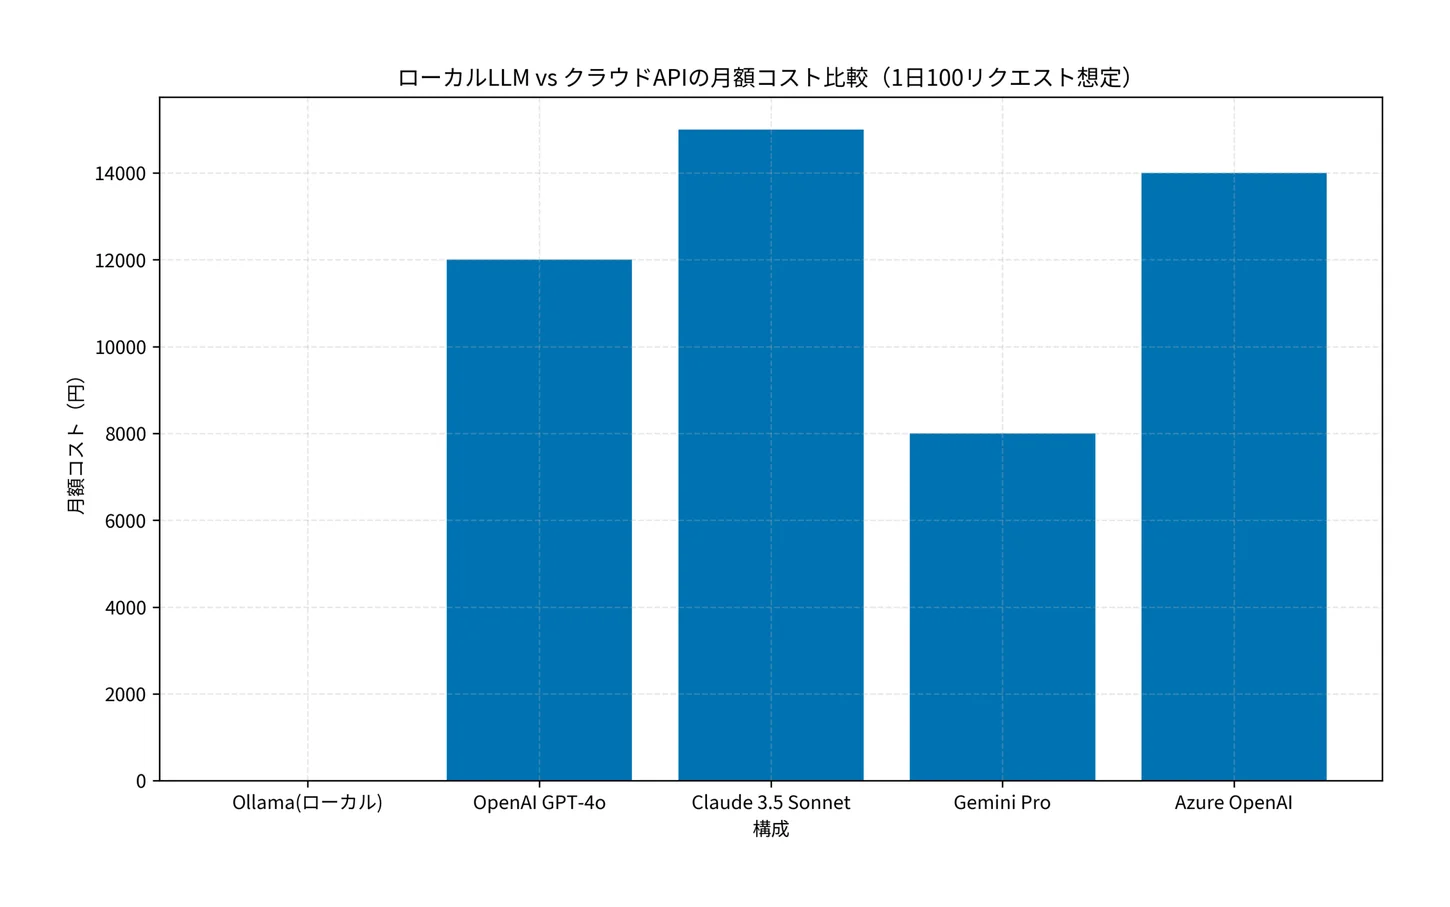
上のグラフの通り、Ollamaを使ったローカル構成では月額コストが実質ゼロになります。1日100リクエスト規模の開発・テスト用途であれば、クラウドAPIと比較して年間10万円以上のコスト削減が見込めます。
IT女子 アラ美ITアライグマステップ2:マルチエージェント協調の実装
基本セットアップができたら、複数エージェントが協調して動作するマルチエージェントシステムを構築します。ここでは「技術記事の自動リサーチ&レビュー」を例に実装します。
役割ベースのエージェント設計
CrewAIの強みは、各エージェントに明確な役割(Role)・目標(Goal)・背景(Backstory)を設定できる点です。これにより、各エージェントが自分の専門領域に集中した出力を生成します。
from crewai import Agent, Task, Crew, Process, LLM

llm = LLM(
    model="ollama/llama3.1:8b",
    base_url="http://localhost:11434"
)

# リサーチャーエージェント
researcher = Agent(
    role="シニアリサーチャー",
    goal="最新の技術トレンドを正確に調査し、エビデンスに基づいたレポートを作成する",
    backstory="あなたは10年以上の経験を持つ技術リサーチャーです。複雑な技術トピックを分かりやすく整理し、信頼性の高い情報を提供することに定評があります。",
    llm=llm,
    allow_delegation=False,
    verbose=True
)

# ライターエージェント
writer = Agent(
    role="テクニカルライター",
    goal="リサーチ結果を元に、読者にとって価値のある技術記事を執筆する",
    backstory="あなたはエンジニア向けメディアで活躍するテクニカルライターです。技術的な正確性を保ちながら、初心者にも分かりやすい文章を書くことが得意です。",
    llm=llm,
    allow_delegation=False,
    verbose=True
)

# レビュアーエージェント
reviewer = Agent(
    role="品質レビュアー",
    goal="記事の技術的正確性、論理的整合性、読みやすさを検証する",
    backstory="あなたはコードレビューと技術文書のレビューを専門とするシニアエンジニアです。細部まで見逃さない正確さと、建設的なフィードバックで知られています。",
    llm=llm,
    allow_delegation=False,
    verbose=True
)
タスクの連鎖とプロセス管理
エージェントを定義したら、それぞれに担当させるタスクと実行順序を組み立てます。CrewAIでは、タスクをsequential(順次実行)またはhierarchical(階層型)で柔軟に実行できます。
タスク同士に依存関係を持たせることができるため、リサーチャーが集めた調査レポートを自動的にライターへ引き渡し、完成したドラフトをレビュアーが検証するという一連のバケツリレーが簡単に作れます。
# タスク定義
research_task = Task(
    description="Ollamaを使ったローカルAIエージェントの最新動向を調査してください。主要なフレームワーク、性能ベンチマーク、実用事例を含めてください。",
    expected_output="技術トレンドレポート(500文字以上)",
    agent=researcher
)

writing_task = Task(
    description="リサーチ結果を元に、エンジニア向けの技術記事を執筆してください。具体的なコード例を含め、実践的な内容にしてください。",
    expected_output="技術記事の本文(1000文字以上)",
    agent=writer,
    context=[research_task]
)

review_task = Task(
    description="執筆された記事をレビューしてください。技術的な誤り、論理の飛躍、改善点を指摘してください。",
    expected_output="レビューコメントと改善提案のリスト",
    agent=reviewer,
    context=[writing_task]
)

# Crewの構成と実行
crew = Crew(
    agents=[researcher, writer, reviewer],
    tasks=[research_task, writing_task, review_task],
    process=Process.sequential,
    verbose=True
)

result = crew.kickoff()
実行プロセスを開始すると、各エージェントがコンソール上で自律的に思考しながらタスクをこなし、次のエージェントへとスムーズに成果物を受け渡していく様子が確認できます。ローカル環境だけでこれほど高度な分業がサクサク動く体験は、一度味わうと本当に感動的ですよ。
エージェントの実行結果をデータベースに永続化すると、継続的な改善サイクルを回せるようになります。
IT女子 アラ美ITアライグマ社内ドキュメントのレビューをローカルのエージェントに任せる進め方の例
社内ドキュメントやマージリクエストのレビューに時間を取られている。けれども、機密保持の決まりで社外のAPIへデータを送れない。そんなチームが、OllamaとCrewAIでレビューを自動化するときの順番を例として整理します。
エージェントの役割を分ける
社内のサーバーにOllamaとLlama 3.1を入れ、CrewAIで次の3体を用意します。
- ドキュメント分析:何が書かれているか、抜けている項目は無いかを読み取ります
- 改善提案:分かりにくい箇所の書き直し案を出します
- フォーマット検証:社内の書式ルールに沿っているかを確かめます
リポジトリとつなぐ
社内GitLabのWebhookと連動させ、マージリクエストが作られたら3体が順にレビューを返すようにします。最初は人のレビューと並行して動かし、エージェントの指摘が人の指摘とどれだけ重なるかを見てから任せる範囲を広げます。
効果を測る
導入前と後で、1週間あたりのレビューにかかる時間と、これまで払っていたクラウドAPIの費用を比べます。データを社外に送らない構成なので、セキュリティ審査の前に、最初からローカル構成で試しておくと、ほかの部署へ広げるときの手戻りを減らせます。
さらに、Claude Codeの実践スキルガイドで紹介したAIコーディング支援と組み合わせると、開発プロセス全体のAI活用が加速します。
IT女子 アラ美ITアライグマさらなる実践・活用に向けて
ローカルAIエージェントの基盤が動くようになったら、実務の現場に合わせてさらに発展させるアプローチを試してみましょう。
モデルのファインチューニング
特定の業界用語や社内ルールに特化したエージェントを作りたい場合は、ベースモデルのチューニングが効果的です。OllamaならModelfileを活用することで、手軽にプロンプトやパラメータを焼き込んだ独自モデルを構築できます。
RAG(検索拡張生成)との統合
エージェントに社内ドキュメントやマニュアルを参照させたいときは、RAGの仕組みを組み合わせます。ChromaDBなどのローカルベクトルデータベースと連携させることで、最新のナレッジを安全に読み込みながら自律タスクを実行させることが可能です。
監視とログ管理
エージェントを日々の業務に組み込むなら、意図しないループやエラーを防ぐためのログ監視も整えておきたいところです。エージェントごとの処理時間やエラー発生率をしっかり可視化しておくと、チーム内でも安心して運用を続けられますよ。
こうした実装経験は、GitHubやブログで発信することで、エンジニアとしての確かな強みにつながります。AIエージェント構築スキルを活かしてフリーランスで高単価案件を狙うならフリーランスエージェント5社比較ガイドも参考にしてください。
IT女子 アラ美ITアライグマよくある質問(FAQ)
Q. OllamaとCrewAIの組み合わせは仕事や商用でも使えますか?
はい、どちらもオープンソースソフトウェア(OSS)として公開されているため、商用プロダクトでの活用が可能です。ただし、Ollama上で動かすLLMモデルごとにライセンス条件が異なる点には注意しておきましょう。例えばLlama 3.1であればMetaのコミュニティライセンスに基づき、一般的なビジネス用途であれば問題なく活用できます。
Q. CrewAIは完全無料で使い続けられますか?
はい、Pythonライブラリとして提供されているオープンソース版は、機能制限なく完全無料で利用できます。エンタープライズ向けの有料クラウドプランも存在しますが、自前のサーバーやローカルPC上でマルチエージェントを動かすだけであれば、追加料金は一切かかりません。
Q. ローカルLLMの動作が重い場合、どう対処すればいいですか?
一番効果的なのは、モデルサイズを8Bなどの軽量クラスに切り替えることや、量子化モデル(Q4_K_Mなど)を活用することです。また、Ollamaのコンテキスト設定(num_ctx)を必要最小限の長さに絞るだけでも、推論速度とメモリ消費を大幅に改善できますよ。
自分のスキルを活かしてフリーランスとして独立したい方は、以下の4社を比較して最適なエージェントを見つけましょう。
| 比較項目 | techadapt | Midworks | レバテックフリーランス | IT求人ナビ |
|---|---|---|---|---|
| 単価帯 | 月60〜120万円高単価特化 | 月50〜90万円中〜高単価 | 月60〜120万円Web系直請け中心 | AI診断適正単価を自動提案 |
| マージン | 10〜20%公開 | 10〜15%公開 | 非公開・案件ごと | 案件ごと |
| 保障・福利厚生 | 限定的案件品質で勝負 | 正社員並み社保・交通費・研修 | 基本的健診・税務サポート | 相談サポートチャット・オンライン |
| 対応エリア | 首都圏東京・神奈川中心 | 首都圏+関西大阪・名古屋 | 首都圏中心+リモート主要都市対応 | 全国対応リモートあり |
| おすすめ度 | 経験3年以上 | 独立初期 | Web系経験者 | B+初心者向け |
| 公式サイト | 案件を探す | 案件を探す | 案件を探す | AI診断する |
IT女子 アラ美ITアライグマまとめ
OllamaとCrewAIを組み合わせることで、クラウドAPIの課金やデータ流出のリスクを気にすることなく、自分だけのマルチエージェントシステムを完全ローカルで構築できます。
本記事で解説した重要なポイントを振り返ります。
- 完全ローカルでコストゼロ・セキュリティ万全:Ollamaを活用することで、API利用料をかけずに何度でもエージェントの試行錯誤を重ねられます。
- CrewAIによる直感的な役割分担:リサーチャー、ライター、レビュアーといった現実のチーム編成と同じ感覚で、自律エージェントの連携ワークフローを設計できます。
- 実務での大きな効率化効果:社内ドキュメントの自動レビューなど、定常的な業務プロセスを自動化することで、開発工数の大幅な削減が可能です。
まずは手元のマシンでOllamaを立ち上げ、軽量なモデルでCrewAIの最初のエージェントを動かしてみてください。複数のエージェントが目の前で自律的に協調し始める面白さと、その実用性の高さをすぐに実感できるはずですよ。
IT女子 アラ美ITアライグマ