 IT女子 アラ美
お疲れ様です!IT業界で働くアライグマです!
ミニPCを買って Ollama を入れたまでは良いものの、HuggingFace や Ollama Library を眺めても「どのモデルをどの量子化レベルで動かせばいいのか」がわからず止まっているエンジニアが増えています。70B級を選んでメモリ枯渇でクラッシュしたり、逆に3B級を選んで使い物にならず結局クラウドAPIに戻ったという声をよく聞きます。本記事では、メモリ16〜32GBのミニPCを中心に64GB・128GBの構成まで、実用に耐えるローカルLLM選定をコーディング・翻訳・要約の用途別に整理して解説します。
ローカルLLMモデル選びで初心者が迷う3つの壁:モデル数と量子化レベル
IT女子 アラ美自宅運用+クラウドPC併用で月額3,300円から、業務環境を独立できます
いつでもどこでもクラウド上PCにアクセス!仮想デスクトップサービス【XServer クラウドPC】
この記事は「どのモデルを動かすか」(ソフトウェア側)を扱います。ミニPC本体の機種選び(CPU・メモリ帯域・GMKtecとMINISFORUMの比較)を探している方は、ローカルLLM用ミニPCおすすめ比較:GMKtec・MINISFORUMを先に読んでください。
ローカルLLMをミニPCで動かしたいエンジニアやPjMが最初に詰まるのが、「どのモデルをどの量子化レベルでダウンロードするか」という選定問題です。HuggingFace や Ollama Library を眺めても、Llama 3・Mistral・Qwen・DeepSeek-Coder など派閥が多すぎて、自分の用途に合う1本を即決できません。ミニPCで実用に耐える構成を組むには、まずこの選定で詰まる構造的な原因を整理することが近道です。
- モデル数の爆発的増加:Llama・Mistral・Qwen・DeepSeek・Gemma・Phi など主要ファミリーだけで毎月のように新バージョンが出ています。Ollama Library 公式に登録されているモデルだけで100種類超、HuggingFace を含めると数千件あり、コーディング特化・日本語特化・長文対応など強みを比較するだけで疲弊します
- 量子化レベルの選択肢が多い:同じモデルでも Q2_K・Q3_K_M・Q4_0・Q4_K_M・Q5_K_M・Q6_K・Q8_0・FP16 と、品質とサイズのトレードオフを表す量子化レベルが5〜8段階用意されています。ファイルサイズが2倍違えば必要RAMも2倍違うため、選定ミスが即クラッシュにつながります
- ベンチマーク数値と実用感の乖離:MMLU・HumanEval・MT-Bench などの公開ベンチマーク数値は参考にはなりますが、ミニPCのメモリ制約下で「コーディング・翻訳・要約」に使ったときの実用感は別物です。スコアが高くてもミニPCでは遅すぎたり、逆にスコアが低くても用途次第で十分使えるケースが多々あります
GPUを持たないミニPC環境でローカルLLMを実用速度に乗せる選択肢としては、量子化以外に「1bit化」というアプローチもあります。このあたりは 1ビットLLM Bonsai-8B完全ガイド:GPU不要で実用レベルの推論を実現する仕組みと導入手順 で詳しく整理しているので、量子化との比較材料として併読することをおすすめします。
IT女子 アラ美 ITアライグマ
メモリ16GBミニPCで32B・70Bモデルを動かそうとした失敗パターンと原因
ミニPCでローカルLLMを導入する際、初心者が陥りがちな典型的な失敗パターンを紹介します。「せっかく購入したのだから最も性能の高いモデルを動かしたい」と考え、メモリ16GBの環境に Llama 3 70B(Q4_K_M、約40GB)を導入しようとして環境ごと停止してしまうケースです。
- 状況:メモリ16GB・SSD 512GBのミニPCに Ollama をインストールし、最初に Llama 3 70B Q4_K_M(約40GB)を
ollama pullで取得しようと試みる。SSDの空き容量が不足してエラー終了したり、より小さい量子化版(Q3_K_M)を取得できたとしても、起動時に深刻なメモリスワップが発生してOS全体が長時間応答不能(フリーズ)になる - なぜうまくいかないのか:モデルファイルサイズだけを見て「OSの仮想メモリやページングで何とかなる」と判断してしまうのが原因です。実際には、LLM推論時はモデルのほぼ全量を高速なメモリ空間に展開する必要があり、16GBの物理メモリに対して30GB以上のモデルを読み込ませればOSのスワップ処理でI/Oが飽和します。推論速度は毎秒1トークンを大きく割り込む極端な低下に陥り、コード補完などの実用は不可能です
- 認識のギャップ:「量子化したから小さくなった=動く」「パラメータ数が大きい=必ず賢い」という2つの誤解が重なりがちです。実際のミニPC運用では、利用可能RAMから OS・常駐アプリ用に4GB程度を引いた残りが「動かせるモデルサイズ上限」になります。16GB ミニPCなら8〜9GB級のモデル、つまり 8B Q4_K_M〜Q5_K_M クラスが現実的な適正ラインです
この構成で無理なく安定稼働するのは、Llama 3 8B Q4_K_M(約4.7GB)と DeepSeek-Coder 6.7B Q4_K_M(約3.8GB)の2モデル併用構成です。Cursor などのエディタからローカルLLMを呼び出す具体的な接続方法は Claude Code・CursorでローカルLLMを使う完全ガイド:Ollama連携でコスト削減とプライバシー保護を両立する設定術 にまとめているので、モデル選定後の実装フェーズで参考にしてください。
IT女子 アラ美ITアライグマメモリ32GBミニPCを用途別3モデルで実用化する構成例:コーディングと翻訳
メモリ32GBを搭載したミニPCであれば、用途別に軽量〜中型モデルを使い分けることで、日常業務での安定稼働とAPIコストの抑制を両立できます。「すべてのタスクを1つの巨大モデルで賄おうとしない」のが運用の定石です。
- 用途別の構成例:コーディング補完には DeepSeek-Coder 6.7B Q4_K_M(約3.8GB)を Ollama で常駐させ、Cursor から呼び出し。翻訳・要約(日↔英・英↔日)には日本語精度が高い Qwen2.5 7B Q4_K_M(約4.7GB)を都度起動。長文要約や設計レビュー用のレポートだけ Qwen2.5 14B Q4_K_M(約9.0GB)を週次で起動する三段運用にします
- 整えるべき前提環境:32GBメモリのうち常駐枠は1モデル(最大9.0GB)に限定し、残り20GB以上をOS・ブラウザ・IDE・Docker用に確保。SSDは1TB NVMe を選定し、3モデル分のキャッシュ(合計約17.5GB)を常時保持。Ollama の
OLLAMA_KEEP_ALIVE=5mを設定し、5分使われなければモデルがメモリから解放される構成にします - 期待できる効果と試算:頻繁に行うコード補完や定型翻訳を手元のローカルモデルに逃がすことで、Claude API や GPT-4o などのクラウドAPI消費量を大きく抑えられます。月1万円前後の従量課金が発生している場合、ローカル活用によってAPI利用量を数千円単位まで削減できる試算です。さらに社外秘コードや未公開メモを手元から外部送信せずに処理できるセキュリティ上のメリットも得られます
「常駐は軽量モデル1つ・重いタスクだけ大型を都度起動」という割り切りが、ミニPC×ローカルLLM運用を成立させる中核ルールです。なお、ミニPC本体の選び方そのもの(メモリ・SSD・冷却設計・メーカー比較)については ローカルLLM向けミニPC4社比較:GMKtecとMINISFORUMの選び方 で実機スペックを比較しているので、購入前に確認してみてください。
IT女子 アラ美ITアライグマメモリ容量別おすすめモデルとQ4_K_M量子化レベルの目安チェックリスト
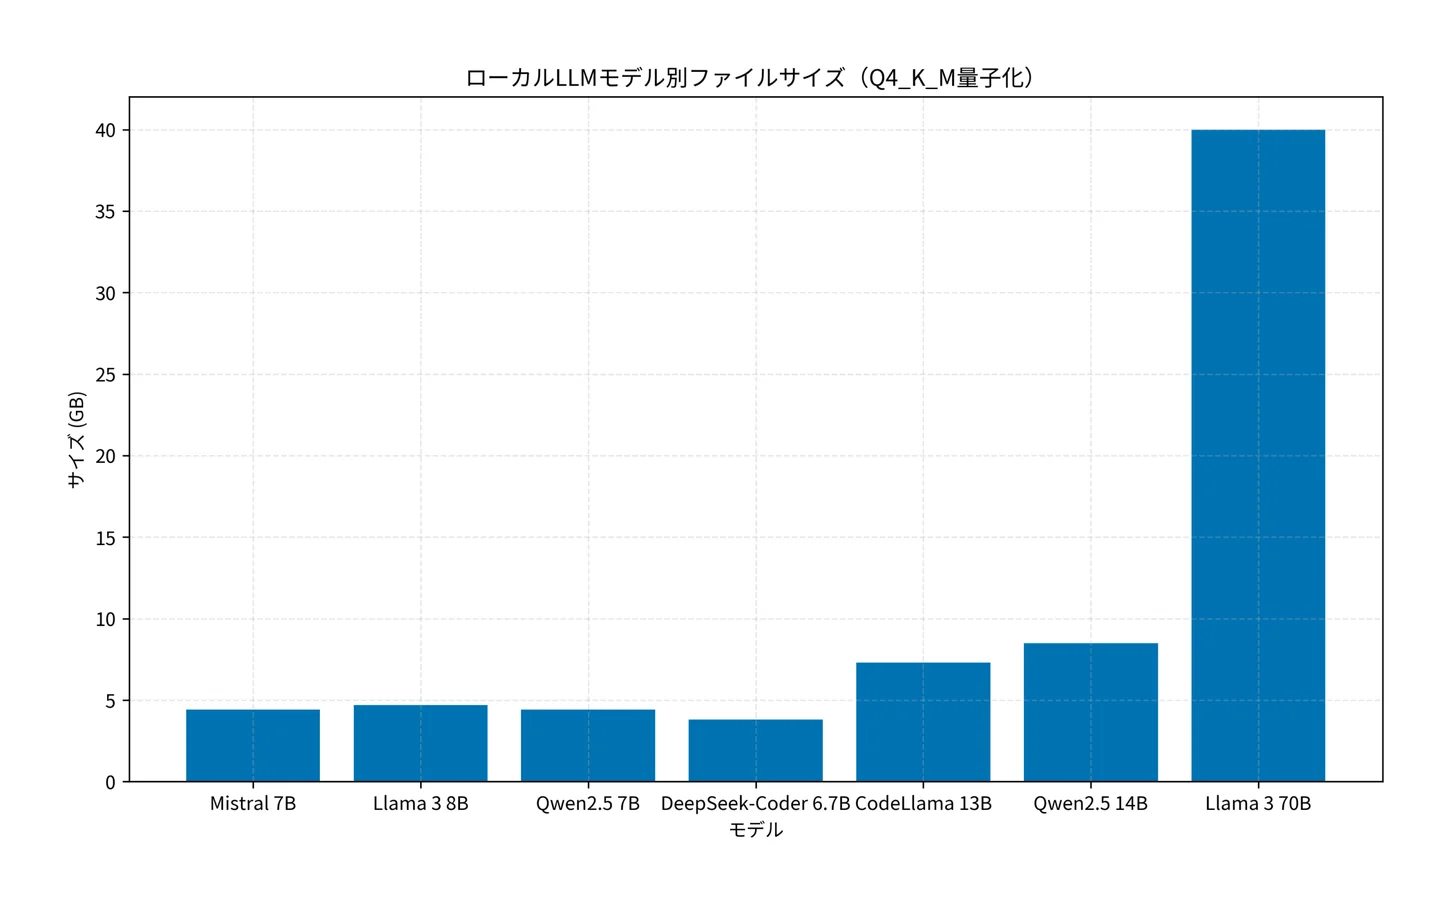
ミニPCでローカルLLM運用を始めるなら、メモリ容量という制約を起点に「動かせるモデルサイズ→用途別に常駐モデル→2モデル目以降」の順で段階的に決めるのが最も失敗の少ないルートです。下のグラフは、Q4_K_M量子化での主要モデル別ファイルサイズです。動かせるモデルサイズの目安は「利用可能RAM − 4GB」で、16GBミニPCなら約12GBが上限になります。
| メモリ容量 | 常駐させるモデルの例(Ollamaのタグ) | 既定タグのダウンロード容量 | 主な適正用途 |
|---|---|---|---|
| 16GB | qwen3:8b / qwen2.5-coder:7b / gemma3:4b | 5.2GB / 4.7GB / 3.4GB | コード補完・軽量チャット・短い翻訳 |
| 32GB | qwen3:14b / qwen2.5-coder:14b / gpt-oss:20b | 9.3GB / 9.0GB / 14GB | 精度重視のコーディング・長文要約 |
| 64GB | qwen3:32b / qwen3-coder:30b / gemma3:27b | 20GB / 19GB / 17GB | 設計レビュー・リポジトリ単位のコード生成 |
| 128GB | llama3.3:70b / gpt-oss:120b | 43GB / 65GB | 70B級・120B級を手元で試す |
容量は Ollama 公式のモデルページ(2026-11-16確認)に載っている既定タグの値です。実際に必要なメモリは、これに会話の長さ(コンテキスト)に応じた作業用の領域が加わるため、表の容量に数GBの余裕を見て選んでください。
- メモリ容量と上限モデルを確認する:16GBなら 8B Q4_K_M クラス(約4.7GB)まで、32GBなら 14B Q4_K_M クラス(約9GB)まで、64GBなら 30B Q4_K_M クラス(約20GB)までが現実解。70B級(llama3.3:70b は約43GB)は128GBクラスのミニPCで試す対象で、64GBではほかのアプリを閉じても余裕がありません
- メイン用途を1つ決めて常駐モデルを選ぶ:コーディング補完なら DeepSeek-Coder 6.7B Q4_K_M、翻訳・要約(特に日本語)なら Qwen2.5 7B Q4_K_M、汎用チャット・分析なら Llama 3 8B Q4_K_M を初手に選ぶと外しません
ollama pullで取得→ollama psで実RAM消費を確認:ダウンロード後に1〜2件プロンプトを投げて、メモリ消費が想定内か検証します。ここでOLLAMA_KEEP_ALIVEを5〜10分に設定し、未使用時は自動解放させる構成にしておくと安全です- EditorやAPIクライアントから接続する:Cursor・Continue.dev・Open WebUI などは
http://localhost:11434を Ollama API として登録するだけで接続できます。ここまでで日常業務に組み込める状態になります - 2週間運用してから2モデル目を追加する:最初から3モデル入れない。1モデルで業務が回ることを確認してから、不足を感じた領域だけ別モデルを追加するのが、容量と運用コストの両面で最も無駄が出ません
ローカルLLMを自分で組める力は、社外秘データを安全に扱いながら開発効率を高めるエンジニアの強力な武器になります。まずは手元のマシンで動かせるモデルを1つ見極め、日常業務のワークフローへ着実に組み込んでいきましょう。
IT女子 アラ美ITアライグマ用途別おすすめモデルとOllamaの導入コマンド:コーディング・日本語・翻訳
メモリ容量で上限が決まったら、次は用途でモデルを選びます。ここでは Ollama 公式のモデルページ(2026-11-16確認)で既定タグの容量を確かめられるモデルに絞って、用途ごとの候補を並べます。
- コーディング(補完・生成):16GBなら qwen2.5-coder:7b(4.7GB)、32GBなら qwen2.5-coder:14b(9.0GB)、64GB以上なら qwen3-coder:30b(19GB、コンテキスト256K)が候補です。補完の待ち時間が気になるなら、まず小さいほうから試します
- 日本語の会話・要約:qwen3:8b(5.2GB)と qwen3:14b(9.3GB)を軸に、gemma3:12b(8.2GB)と比べます。日本語の自然さはベンチマークの数値より、自分が普段書く文章で比べたほうが確実です
- 翻訳・長い資料の読み込み:コンテキストの長さが効くため、gemma3(128K)や qwen3:30b(256K)が候補です。長い資料を渡すほど作業用のメモリが増えるため、表の容量より余裕を多めに見ます
導入は、候補を1つ取得して試し、実際のメモリ消費と速度を確かめる順に進めます。
# 1. 候補のモデルを取得する(既定タグは Q4_K_M)
ollama pull qwen2.5-coder:7b

# 2. --verbose を付けて実行すると、最後に eval rate(1秒あたりのトークン数)が出る
ollama run qwen2.5-coder:7b --verbose "PythonでCSVを読み込んで列ごとの平均を出す関数を書いて"

# 3. 別のターミナルで、読み込まれたモデルの容量とCPU/GPUの割合を確認する
ollama ps

# 4. 品質を上げたいときだけ Q8_0 を取得して比べる
ollama pull qwen3:8b-q8_0
Q4_K_MとQ8_0の容量の差
同じモデルでも、Q8_0 は Q4_K_M の約1.7倍の容量になります。Ollama 公式の値では、qwen3:8b は Q4_K_M が5.2GB・Q8_0 が8.9GB、qwen3:14b は9.3GB・16GBです。16GBのミニPCで Q8_0 を選べるのは8Bクラスまでで、14Bクラスの Q8_0 は32GB以上が前提になります。まず Q4_K_M で動かし、回答の質に不満がある用途だけ Q8_0 に上げてください。
推論速度(tok/s)の目安
文章を1トークン生成するたびにモデルの重みをメモリから読み出すため、生成速度の上限は「メモリ帯域 ÷ モデルの容量」でおおよそ見積もれます。DDR5-5600 を2枚差ししたミニPC(帯域は計算上約89.6GB/s)なら、qwen3:8b(5.2GB)で毎秒約17トークン、qwen3:14b(9.3GB)で約10トークンが計算上の上限で、実際の速度はこれより下がります。qwen3:30b や gpt-oss のように一部の重みだけを使う MoE 型のモデルは、容量のわりに速く動きます。手元の正確な値は、上のコマンドの eval rate で確かめてください。メモリ帯域の大きいCPUを選ぶ考え方は、ローカルLLM用ミニPCおすすめ比較のメモリ帯域の節で比べています。
IT女子 アラ美ITアライグマよくある質問
Q. メモリ8GBのミニPCでもローカルLLMは動かせますか?
A. 動かせるのは Phi-3 Mini(3.8B Q4_K_M、約2.3GB)や Gemma 2B Q4_K_M(約1.5GB)クラスまでです。コード補完用途では精度が物足りない場面も多いため、本格運用したいなら最低でもメモリ16GBのミニPCを選び直すことをおすすめします。8GB環境はあくまで「動作確認・遊び」用と割り切るのが現実的です。
Q. GPUのないミニPCでも実用速度が出ますか?
A. CPU推論でも、8B Q4_K_Mクラスなら毎秒5〜10トークン程度は出ます。コーディング補完・翻訳・要約など「短い応答」を主とする用途なら体感的に問題ありません。逆に、長文の生成や設計レビューなど「数千トークン出力」を求める用途では、GPU内蔵モデル(AMD Ryzen 7000シリーズの内蔵Radeonなど)か外付けeGPUの検討余地があります。
Q. 量子化レベルは Q4_K_M 以外を選んだ方が良いケースはありますか?
A. 精度を最優先したい場合は Q5_K_M・Q6_K を、サイズを最優先したい場合は Q3_K_M を選びます。ただし、ミニPC前提では Q4_K_M が「品質・サイズ・速度」の3点でバランス最適というのが2026年時点のコミュニティ標準的な見解です。最初は Q4_K_M から入り、不足を感じた次元だけ調整するのが効率的です。
Q. 法人利用ではローカルLLMだけで運用できますか?
A. 機密情報を扱う場面ではローカルLLMが最有力ですが、最新モデル比較や大量バッチ処理ではクラウドAPIが優位です。実務では「機密データはローカル、公開データはクラウド」のハイブリッド運用が主流です。クラウドPCやレンタルサーバーを業務専用に切り出す場合の選び方は エンジニア向けXServer用途別比較ガイド に詳しい比較がまとまっているので、ローカル+クラウドのいいとこ取り構成を組む際の参考にしてください。
IT女子 アラ美ITアライグマまとめ
ミニPCでローカルLLMを実用速度で動かす鍵は、「メモリ容量−4GB」を上限としてモデルサイズを決め、用途別に常駐1個+切替2〜3個の三段運用に持ち込むことです。70B級を最初に狙ってクラッシュさせるよりも、8B Q4_K_Mから入って業務に組み込み、必要なときだけ14B級に上げる進め方の方が、結果的にコストも運用負荷も抑えられます。
- 動かせるモデル上限は「利用可能RAM−4GB」:16GBミニPCなら約12GBが上限、70B級は最初から候補から外して問題ない
- 用途別に常駐1個+切替2〜3個:コーディング DeepSeek-Coder 6.7B、翻訳・要約 Qwen2.5 7B、重い分析 Qwen2.5 14B が2026年時点のバランス解
- 定型タスクのローカル化でAPIコストを抑制:コード補完や下訳を手元で完結させ、社外秘データを安全に扱えるメリットが大きい
完璧な構成を最初から目指さず、まずは1モデルだけ ollama pull で取得し、2週間日常業務で使ってみるところから始めてみてください。「クラウドAPIに毎月いくら払っているか」を1度棚卸しするだけでも、ミニPC投資の回収期間が現実的に見えてきます。最初の選定で迷ったら、本記事の「メモリ容量別チェックリスト」に立ち戻れば外しません。
また、ミニPC本体のスペック比較やメーカー選びから始めたい方は、ミニPC主要メーカー4社の特徴・スペック比較も併せて参考にしてください。
IT女子 アラ美ITアライグマ